Grabar el modelo en el silicio: por qué AMD ha comprado un chip que no se puede actualizar
Por qué AMD compró Taalas: cómo tallar un modelo de IA directamente en el metal de un chip elimina cuellos de botella y ahorra costes en producción.
(🇺🇸 Read the English version of this article here)
Si abres LinkedIn cualquier mañana, el relato dominante es que la inteligencia artificial es una cuestión puramente de software. Que todo se reduce a ajustar algoritmos, encadenar modelos en la nube y esperar a que el código resuelva cualquier ineficiencia.
Es una lectura superficial que ignora la realidad física de los servidores.
Cualquiera que gestione presupuestos de infraestructura o arquitectura sabe la verdad: la IA se ejecuta en máquinas físicas que consumen una barbaridad de electricidad, disipan cantidades ingentes de calor y cuestan una fortuna.
A mediados de agosto de 2026, AMD cerró una operación multimillonaria que ha pasado desapercibida fuera de los círculos especializados, pero que altera de lleno la economía de la computación: la compra de Taalas, una empresa que ha apostado por una dirección radical: fabricar un chip donde el modelo de IA está grabado físicamente en el metal y no se puede actualizar.
Para entender por qué esta decisión tiene todo el sentido económico, hay que mirar primero al cuello de botella que hoy encarece cada petición que procesas.
El verdadero problema: el cocinero que pasa el día caminando
¿Por qué las facturas de servidores y las suscripciones de IA se están disparando en todas las empresas? Porque los chips actuales tienen un defecto de diseño garrafal para este tipo de tareas.
Imagina que contratas al mejor chef del mundo. Es capaz de cortar verduras y cocinar a la velocidad de la luz. Pero hay un problema absurdo en el diseño de su restaurante: en la cocina no hay estantes. Cada vez que necesita un grano de sal, tiene que salir de la cocina, caminar un kilómetro por un pasillo hasta el almacén, coger la sal, volver caminando y echarla a la sartén. Y si luego necesita pimienta, tiene que volver a hacer el mismo viaje de un kilómetro.
Eso es exactamente lo que hace un chip de IA tradicional hoy en día:
- El procesador es el súper cocinero.
- La memoria es el almacén lejano.
Cuando una IA te escribe una respuesta, no piensa la frase entera de golpe: la genera palabra por palabra. Y para escribir cada una de esas palabras, el procesador se ve obligado a viajar hasta la memoria para consultar todo lo que sabe el modelo.
¿El resultado? El chip gasta el 90% de su tiempo y de tu dinero en electricidad simplemente "caminando" por los cables para mover datos, no en calcular. Por eso los chips líderes del mercado cuestan más de 30.000 euros cada uno: no estás pagando por la inteligencia, estás pagando por una autopista de memoria carísima y complicadísima de fabricar para que el cocinero camine un poco más rápido.
La solución radical: tallar la receta directamente en la mesa
Lo que ha hecho la gente de Taalas es tan simple como salvaje. Dijeron: "Basta de paseos".
En lugar de tener una memoria separada a la que ir a buscar las recetas, han tallado la receta y todos los ingredientes directamente en el acero de la mesa de la cocina.
En el mundo de los microchips, esto significa que no compras un procesador genérico al que luego le "cargas" un programa de IA. Han fabricado un chip cuyos transistores y circuitos físicos ya tienen la forma exacta de un modelo de IA concreto (en este caso, el modelo abierto Llama de Meta).
El chip no ejecuta la IA: el chip ES la IA.
Al eliminar por completo el paseo al almacén, la física hace su magia:
- Velocidad de infarto: Mientras que las mejores tarjetas del mercado escupen unas 100 o 150 palabras por segundo, este chip alcanza 17.000 palabras por segundo. Una barbaridad que deja en ridículo a cualquier alternativa.
- Coste energético mínimo: Funciona con la misma electricidad que consume un ordenador normal de oficina y se refrigera con aire normal, sin necesidad de las complejas instalaciones de refrigeración líquida que exigen los grandes centros de datos.
La letra pequeña: está escrito en piedra
Cualquier directivo sensato se estará haciendo ya la pregunta del millón: ¿dónde está la trampa?
La trampa es evidente: cero flexibilidad.
Este chip está literalmente fundido en metal. Si tu empresa compra un servidor con estos chips para utilizar un modelo concreto y al mes siguiente sale una versión nueva y más moderna, no puedes pulsar un botón de "actualizar software". Tu chip no sabe hacer otra cosa en la vida. Para cambiar de modelo tendrías que fabricar un chip nuevo.
Para los entusiastas de la tecnología que quieren probar la última novedad cada semana, esto es una aberración. Pero para una empresa que mira la cuenta de resultados, la perspectiva es completamente distinta.
Por qué a tu empresa le interesa una IA "tonta pero rapidísima"
Pregúntate con honestidad para qué necesita tu empresa la IA en el 80% de sus procesos diarios:
- No la necesitas para escribir poesía ni para filosofar sobre el sentido de la vida.
- La necesitas para clasificar 50.000 facturas al día, extraer el NIF y el importe, y meterlos en tu ERP.
- La necesitas para leer los correos de atención al cliente y redirigirlos en milésimas de segundo al departamento correcto.
- La necesitas para comprobar si los contratos de tus proveedores cumplen con la normativa interna.
Para ese tipo de fontanería empresarial, no necesitas la IA más cara y cambiante del mundo; necesitas un martillo fiable, ultraveloz y que cueste céntimos de operar.
Tener una máquina que no se puede actualizar pero que resuelve tareas rutinarias al instante, metida en un servidor dentro de tu propia oficina (sin enviar datos confidenciales de clientes a empresas externas y sin pagar suscripciones mensuales millonarias), es una ventaja competitiva descomunal.
La economía real frente al sobrecoste de la nube
Por eso AMD ha puesto el talonario sobre la mesa. Saben que la era del derroche, en la que las empresas quemaban presupuestos alquilando superordenadores generalistas para tareas repetitivas, tiene los días contados.
El verdadero avance en la adopción empresarial no vendrá de promesas abstractas en redes sociales, sino de ingenieros rediseñando el silicio para que procesar datos sea técnica y económicamente sostenible.
La próxima vez que leas sobre el último modelo multimillonario, acuérdate del cocinero: el salto de eficiencia no está en añadir más parámetros, sino en dejar de pagar el paseo hasta el almacén.
Referencias y lecturas recomendadas
- AMD Investor Relations (Agosto 2026): AMD Acquires Taalas to Advance Compute Solutions for Rapidly Growing AI Inference Market — Comunicado oficial de prensa sobre el acuerdo de adquisición.
- Taalas: Taalas Inc. — Direct-to-Silicon AI — Portal oficial de la compañía y arquitectura de silicio dedicada a modelos de IA.
- Simon Willison’s Weblog: Taalas: Silicon Llama at 17,000 tokens per second — Análisis del benchmark de 17.000 tokens/s y la cuantización mixta de Llama 3.1.
- Jon Peddie Research: AMD buys Taalas and a very different idea about AI inference — Análisis sobre la estrategia de construir hardware en torno a un modelo fijo.
- StorageReview: AMD to Acquire Taalas: The Startup Building Silicon Around One Model — Desglose técnico de la arquitectura y la eliminación del cuello de botella de memoria.
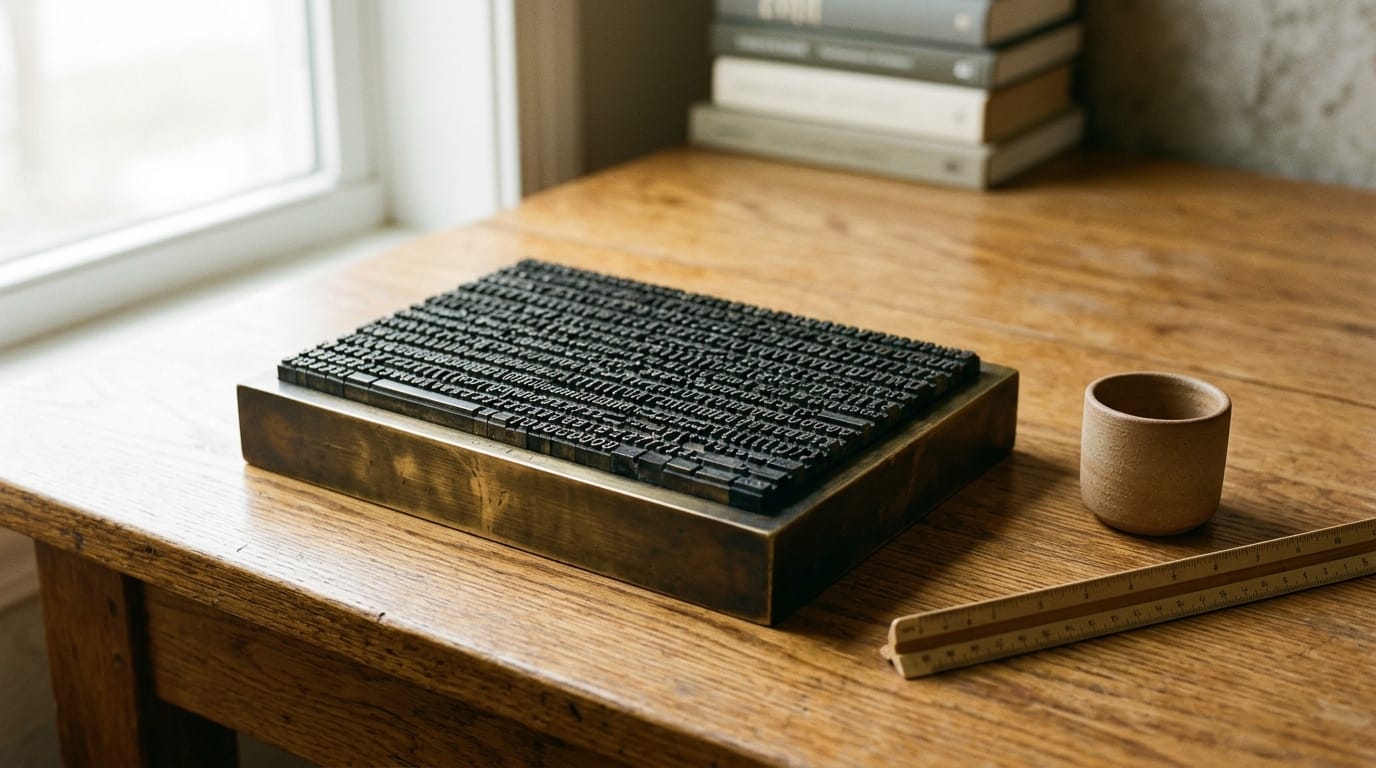
Crédito de imagen: Syncroma Studio. Fotografía conceptual analógica: tipos móviles de imprenta metálicos fijados rígidamente en un bloque de bronce sobre madera de roble, simbolizando un modelo de IA grabado físicamente en el silicio sin posibilidad de reescritura.
Sistemas reales, sin humo corporativo Real systems, zero corporate hype
Recibe los análisis a fondo sobre arquitectura, consumo de recursos y computación de bajo nivel directamente en tu bandeja de entrada. Get deep-dive software architecture, resource consumption metrics, and low-level computing essays delivered straight to your inbox.
Suscribirse a Syncroma Subscribe to Syncroma