El gran engaño de la IA: Por qué ChatGPT no piensa (y por qué da igual)
Desmontamos el humo corporativo. Qué es realmente un LLM, el mito de la inteligencia y cómo predice texto por pura estadística.
(🇺🇸 Read the English version of this article here)
Abres LinkedIn un martes cualquiera y la pereza es real. Otra vez los tres autoproclamados "Gurús de IA" de turno soltando el mismo discurso motivacional, asegurando que los Modelos de Lenguaje (LLMs) están a punto de alcanzar el razonamiento humano, que sienten empatía y que van a revolucionar el mundo en dos semanas.
Cierras la pestaña porque sabes cómo funcionan las máquinas por debajo. Vamos a dejarnos de humo y a hablar de esto entre nosotros. ¿Qué demonios es realmente un LLM cuando rascas la pintura?
La verdad duele, pero alguien tiene que decirla: esta tecnología no piensa, no razona y no tiene ni idea de lo que te está diciendo.
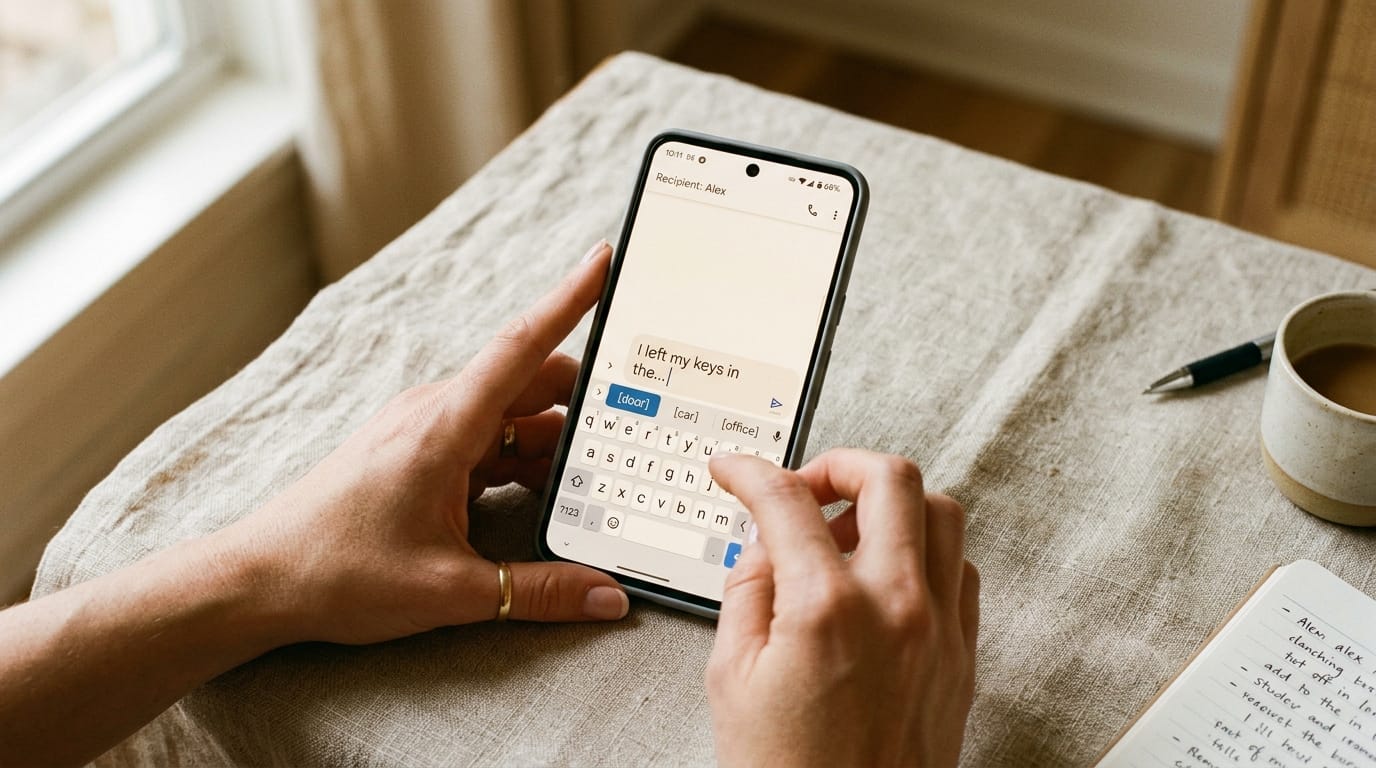
Para entenderlo sin matemáticas densas, piensa en el teclado de tu móvil. Cuando escribes "Me he dejado las llaves puestas en la...", tu teclado automáticamente te sugiere "puerta" o "cerradura". Tu móvil no entiende qué es una llave, ni sabe cómo funciona una cerradura de metal. Simplemente ha analizado tus mensajes anteriores y sabe que, estadísticamente, la palabra "puerta" suele ir detrás de "llaves puestas".
Un LLM es exactamente eso: un motor de autocompletar hipervitaminado.
En lugar de leerse tus mensajes de WhatsApp, se ha devorado medio internet. Cuando tú le haces una pregunta técnica, la máquina no "comprende" tu problema. Lo que hace es cruzar todo ese texto masivo que ha procesado y calcular matemáticamente cuál es la siguiente pieza de palabra (el siguiente token) que debería ir a continuación.
Para el modelo, la palabra "SQL" tiene un 89% de probabilidad de ir seguida de "Server", un 10% de ir seguida de "Injection" y un 0,0001% de ir seguida de "lechuga". Elige la más probable, la imprime en pantalla, y vuelve a calcular la siguiente. Así, palabra por palabra, construye frases impecables que suenan inteligentes. Magia estadística impulsada por miles de tarjetas gráficas haciendo multiplicaciones a lo bestia.
Si es tan tonto, ¿por qué parece tan listo?
Ahí está nuestro autoengaño. Como los humanos usamos el lenguaje para demostrar inteligencia, cuando vemos a una máquina generar sintaxis perfecta, asumimos que "entiende".
Pero que no te engañen: su superpoder no es el razonamiento, es la fuerza bruta. Y eso, para los informáticos, vale su peso en oro. Nosotros tardamos tres días en leernos una documentación técnica infumable; a un modelo le cuesta tres segundos cruzar 10.000 páginas y escupirte el bloque de código exacto que estabas buscando. Esa velocidad absurda de compresión de datos es lo que de verdad nos ahorra horas de tareas repetitivas.
El cerebro en el tarro
Pero aquí viene la bofetada de realidad para los gurús de LinkedIn. Un LLM, por muy rápido que procese, es un cerebro encerrado en un tarro de cristal. Es sordo, ciego y no tiene manos.
Tú le pasas un texto y te devuelve un texto. Ya está. Un chat no puede conectarse a tu base de datos por sí solo. No puede interactuar con tus servidores. No puede compilar un proyecto ni arreglar un fallo real en tu código.
Para que esta "calculadora de palabras" deje de ser un oráculo de chat y se convierta en un sistema complejo que trabaje en el mundo real, necesita que le pongamos manos. Necesita un protocolo para tocar tus herramientas.
Y de esas manos —los famosos MCP (Model Context Protocol) que son la verdadera revolución para los desarrolladores— es de lo que hablaremos en el próximo post.
Crédito de imagen: Syncroma Studio. Fotografía editorial analógica: texto predictivo en interfaz móvil con selección estadística de palabra.
Sistemas reales, sin humo corporativo Real systems, zero corporate hype
Recibe los análisis a fondo sobre arquitectura, consumo de recursos y computación de bajo nivel directamente en tu bandeja de entrada. Get deep-dive software architecture, resource consumption metrics, and low-level computing essays delivered straight to your inbox.
Suscribirse a Syncroma Subscribe to Syncroma